离线缓存、补传与积压处理
缓存用于保留已经进入转发目标、但尚未成功发送的记录。要判断补传是否有效,应在离线期间产生多个不同值,再到恢复后的接收窗口逐条检查。
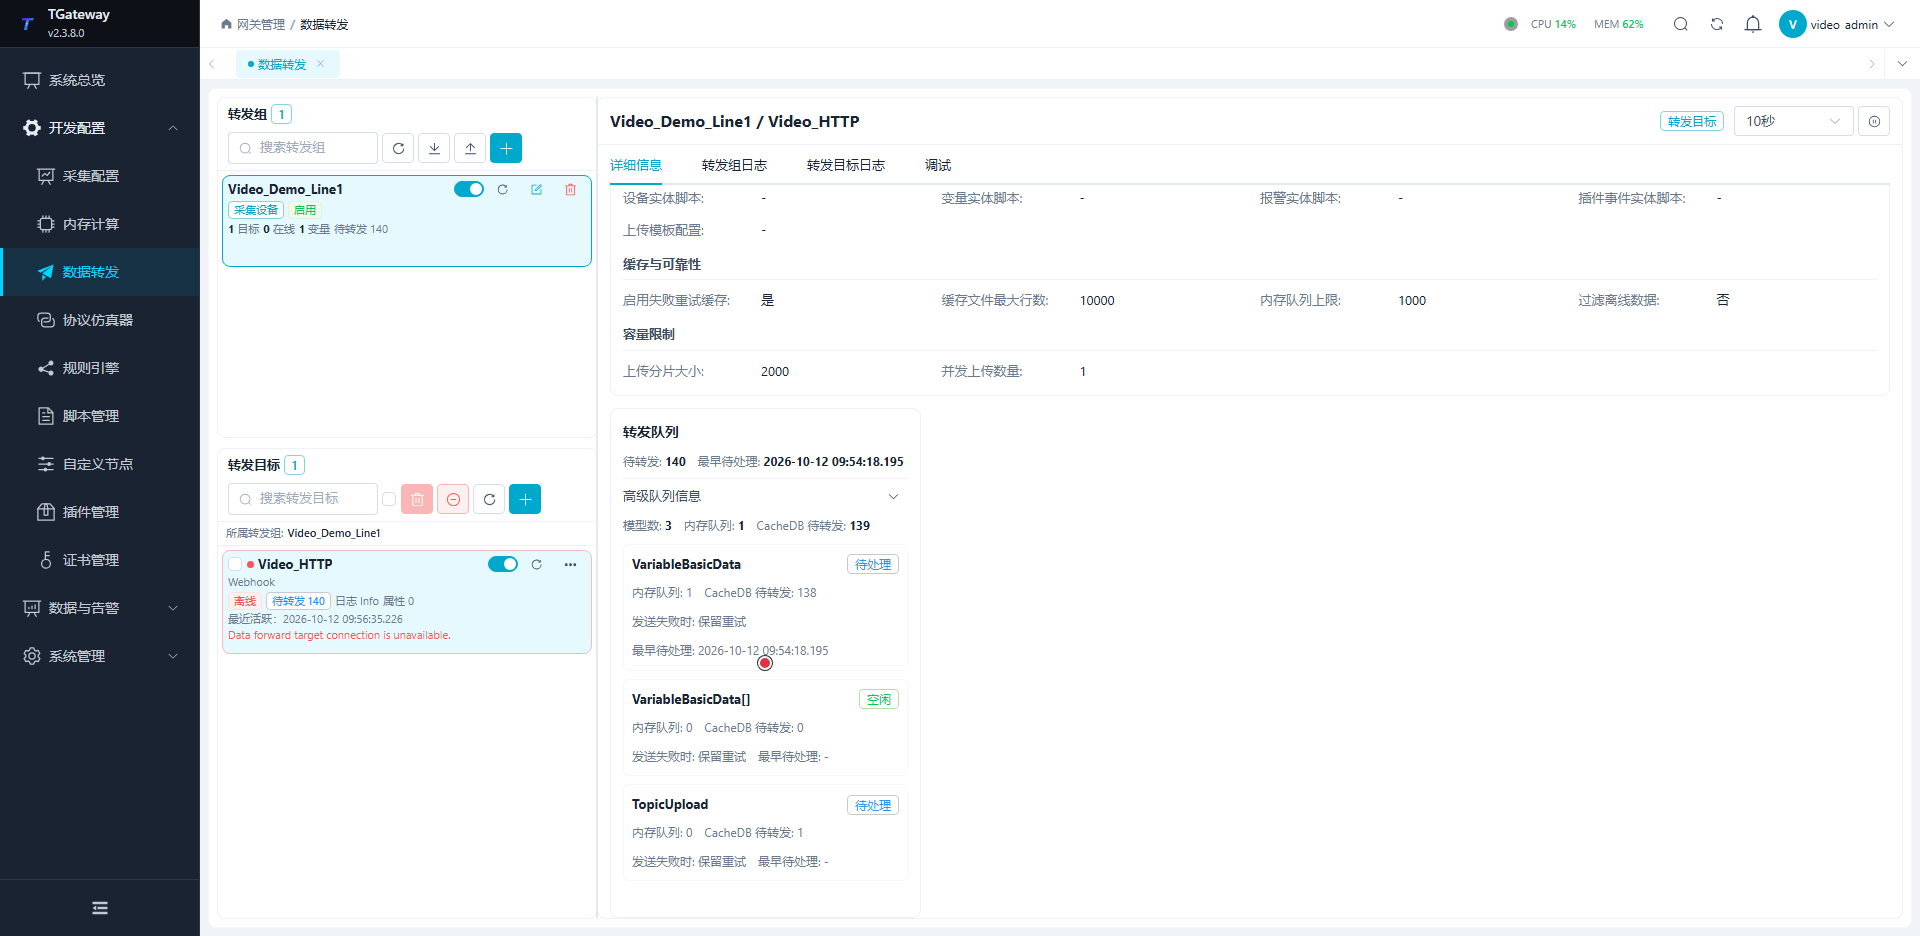
进入“开发配置 → 数据转发”,选择支持缓存的目标,编辑“缓存与可靠性”和“容量限制”。保存后在目标详情或“调试 → 缓存出站”观察实际队列。
设置缓存容量
配置各层容量
| 参数 | 作用 |
|---|---|
| 启用失败重试缓存 | 开启后保留断线或发送失败的记录供后续重试;关闭后失败记录不保留重试。运行中仍可能经过 CacheDB 暂存。 |
| 内存队列上限 | 短时间的内存缓冲阈值。达到后先尝试落盘;落盘失败时保留已接收记录并拒绝新记录,由上游重试。 |
| 缓存文件最大行数 | 每个 CacheDB 出站模型队列的记录行数上限,超过后淘汰最旧记录;它不是字节数,也不是所有队列的合计行数。 |
| 上传分片大小 | 相应变化缓存或补发队列的读取批量上限,与转发组最大批量作用于不同阶段;完整周期快照可保留组批次边界。 |
| 并发上传数量 | 由插件发送方式决定。MQTT 单连接、SyncBridge 顺序确认等目标应按插件要求保持 1。 |
| 过滤离线数据 | 目标出队时过滤离线变量;组级在线过滤还会在前面影响进入目标的范围。 |
目标接收速度持续低于生产速度时,提高缓存只能延迟耗尽,仍需调整生产周期、接收能力或批量策略。持续关注增长速度、最老记录年龄和磁盘可用空间。
本页 HTTP 练习使用按模型分队列的通用上传缓存。历史数据目标使用自身队列,数值和字符串共同占用行容量,分片按历史记录读取。双库镜像的可靠队列满额时拒绝新事件,不采用淘汰最旧待发数据的策略;应按对应目标页核对容量。
容量超限会发生什么
若某个持久队列只允许 3 行,离线期间产生更多记录,最旧待发记录可能被淘汰。之后将容量恢复为较大值,只影响今后的保留能力,无法找回已淘汰数据。已经取出并正在发送的批次仍可能到达,容量裁剪不会撤销它;验收淘汰时应先确认被比较的旧批次已实际失败并回到待发状态。
一行可能是一条变化,也可能是一组快照。可以先用实际队列增长率估算容量:预计行数 = 每秒进入该队列的行数 × 计划离线秒数,再为突发和恢复期间新增数据留余量。磁盘容量还取决于每行载荷大小,应结合真实文件增长测量。
改变内存阈值后,需要在相同输入节奏和相同慢响应窗口下比较实际内存峰值;配置中的上限数字不能直接当作测量结果。
在相同输入下比较策略
- 失败保留:先记录并排除已有积压,关闭失败重试缓存,停止测试接收端并确认出现真实发送失败。依次产生
2101、2102、2103,每个值保持到组触发完成,最后保持2104。仅对日志和队列状态已确认按失败策略处理的旧记录检查是否重放;恢复时仍在正常暂存或在途的记录须另记。再开启缓存,用另一组值重复,核对失败保留、旧值和新值送达。 - 持久容量:将一个队列的上限设为
3,产生超过三份实际模型记录,核对队列不超过上限、恢复后较新记录送达、最早记录已淘汰。恢复大容量后继续检查新数据。 - 内存转存:接收端正常接收但延迟响应,例如
3.5秒,HTTP 超时保留5秒,组周期用100毫秒。先使用内存阈值2,再改为100,比较相同窗口的内存峰值和持久行数;不要把慢响应当作发送失败。
达到内存阈值时优先转存,落盘失败会保留原批次并拒绝新批次,由上游处理失败。不要把内存上限解释为无限等待或必然丢弃已经接收的旧记录。
关闭失败重试缓存不等于清空正常队列,也不撤回已经发出的请求。接收端已处理但确认丢失、恢复时尚未尝试发送,以及恢复后重新生成的当前快照,都可能表现为再次收到相同值。用源时间、记录时间和接收边界区分这些情况,不能仅凭相同值判断失败缓存仍在重放。
查看并验证补传
读懂缓存出站状态
| 显示项 | 判断方法 |
|---|---|
| 模型 | 区分变量变化、周期快照、设备、报警和事件等实际队列,逐行核对容量。 |
| 内存队列 | 已接收但尚未落盘的数量,属于短时间缓冲。 |
| CacheDB 行数 | 已持久化的待处理记录;一行不一定等于一个变量。 |
| 保留重试数 | CacheDB 中因失败而保留的部分,已包含在数据库行数内,不应重复相加。 |
| 最早事件 | 当前积压的时间起点,应结合当前时间计算年龄,而不只看记录总数。 |
| 最近错误 | 当前发送或处理失败原因,与历史累计失败次数分别阅读。 |
关闭失败重试后,正常暂存、在途数据和持续新输入仍可能形成瞬时队列;应看失败保留计数和恢复后的旧值,不能要求所有队列在每个瞬间都为零。恢复完成要同时满足旧值已到达、积压持续回落以及新值继续发送。
内存数量、持久行数和请求返回时间并非同一时刻的原子快照。诊断查询本身也可能等待存储操作;比较峰值应保留连续样本,不能把一次响应的返回时间当成所有计数的共同采样时间。目标重新初始化期间暂时没有队列列表,也不表示积压已经归零。
验证一次完整补传
先在测试环境选择一个可控制的目标和变量,不关闭生产共用服务。
- 只将测试变量加入组,启用失败重试缓存,确认接收端能够收到正常值。
- 记录接收端当前边界与时间,再中断该测试接收服务。
- 在离线期间依次输入两个或多个不同值,例如
1500、1700。每个值至少保持到一次相应组触发完成,并确认采集端和目标队列确实记录了该样本。 - 查看队列增长、最早事件和最近错误;保留当前值之外的离线样本。
- 恢复同一个接收端点,从新的接收窗口检查两个旧值是否均到达。
- 等待积压回落,再输入一个新值,确认恢复后的正常发送也继续工作。
恢复后只收到最终当前值,不能证明中间历史被补传。检查时需要设备、变量、值和来源时间共同匹配;重试可能产生重复,接收端应按业务身份处理幂等。
理解交付边界
分清批次、分片和正文
转发组分批决定哪些输入组成一次生产结果;目标分片决定从相应缓存模型取多少记录;列表或字典决定最终正文的外层结构。周期快照可能保留整批边界,不能用分片数字推断所有正文长度。
例如四点按独立记录进入 Webhook 目标,列表开启时,分片 1 形成单元素数组,较大分片可形成多元素数组。并发在不同 URL 的慢响应请求上可能形成重叠,但不会改变采集周期,Kafka 发送锁等插件限制也可能使上传仍然串行。
离线过滤也分两层验证:组级过滤影响生产范围,目标级过滤影响出队数据。关闭过滤时,离线点可能以最后值和 IsOnline=false 发送;开启后排除该点,其他在线点仍继续发送。恢复源端后,该点应重新进入消息,已有离线历史不会因此被删除。
缓存与消息确认的边界
| 路径 | 需要额外确认的事项 |
|---|---|
| MQTT 客户端 | Broker 确认与下游业务处理是不同环节;确认 QoS、持久会话、消费者和重复处理。 |
| MQTT 服务端 | 发布成功不代表离线订阅者已收到;还需确认订阅者的会话和消息接收。 |
| 自定义 Webhook | 当前插件以 HTTP 2xx 判断发送成功;业务 JSON 中的失败码不会自动触发重试。 |
| 历史数据目标 | 通过数据库写入结果与自身缓存处理失败;恢复后查询旧记录及新记录。 |
| SyncBridge | Edge 等待 Hub 应用确认后删除出站批次。Hub 后续数据库目标按自己的缓存写入,该确认不等于数据库提交。 |
缓存只保存组实际产生且未被淘汰的数据。目标停用期间没有产生的记录、被范围或过滤排除的数据,以及已被字典或脚本合并的采样,不能依靠重连自动还原。
中心历史补录
通过 Gateway MQTT 或 SyncBridge 汇聚数据时,中心需要单独配置历史数据目标,并把对应镜像变量加入中心存储范围。
- 在边缘启用缓存,保留来源采集、变化和记录时间。
- 在中心配置接收端和历史目标,先验证实时采集与正常入库。
- 中断链路并产生多个来源值,恢复后按离线期间的时间窗口查询中心历史。
- 同时核对中心实时值保持最新,避免旧采样补录使当前值回退。
- 对比缺失和重复,分别记录,不把“没有缺失”解释为所有路径都保证恰好一次。
各协议的来源时间与补录规则见数据转发的离线历史说明和同步桥接。
常见问题
| 现象 | 检查方法 |
|---|---|
| 断线后队列一直为零 | 核对组成员、触发、在线过滤、目标启用状态和失败重试策略。 |
| 服务恢复后积压不下降 | 查看认证、请求格式、响应状态、超时、分片、接收端处理速度及磁盘错误。 |
| 收到重复记录 | 核对确认丢失与重试,按来源身份设计去重,保留来源时间。 |
| 没有最早的几个离线值 | 检查队列容量、过滤、分批和模型合并;增大容量不会恢复已淘汰记录。 |
| 中心实时正常,历史缺失 | 检查中心历史组范围、目标连接、时区、来源时间以及数据库出站队列。 |